一、AI 没有自己的账号,权限跟着登录人走
很多人担心 AI 是不是另开了一个「超级账号」,能绕过系统的权限设置。答案很直接:AI 没有自己的权限。它用的是你当前的登录身份——你能查到的,它才能查到;你查不到的,它同样查不到。换个账号登录,AI 能看到的范围随之改变,不需要为 AI 单独维护一套账号体系。
这套逻辑建立在 HR 系统原有的权限架构上:用户、角色、组织、字段、数据各层权限,早就在系统里配好了。AI 只是沿着这套既定的边界工作,不另起炉灶。
二、数据范围自动过滤,部门与组织边界清晰
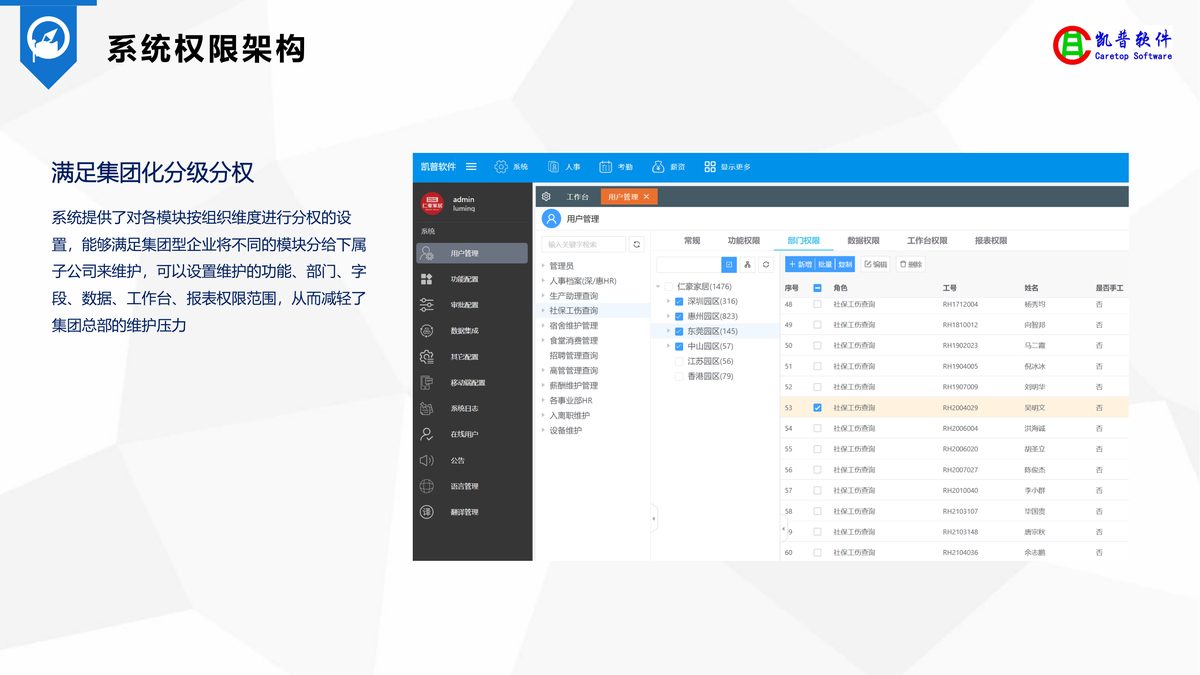
对集团型企业,分权是刚需:总部的 HR 要看全集团,子公司的 HR 只看自己那摊。系统提供按组织维度的分权设置——不同模块可以分给下属公司维护,功能、部门、字段、数据、工作台、报表的权限范围都能分别划定,减轻总部的维护压力。
换算到 AI 查数场景:你只能看到本部门的数据,AI 返回的就只有本部门;你被授权查看某个子公司,跨出去的部分不会被带出来。过滤发生在数据返回的那一刻,靠的是系统规则,不是靠 AI 自觉。
三、敏感字段返回即打星,明文不落在对话里
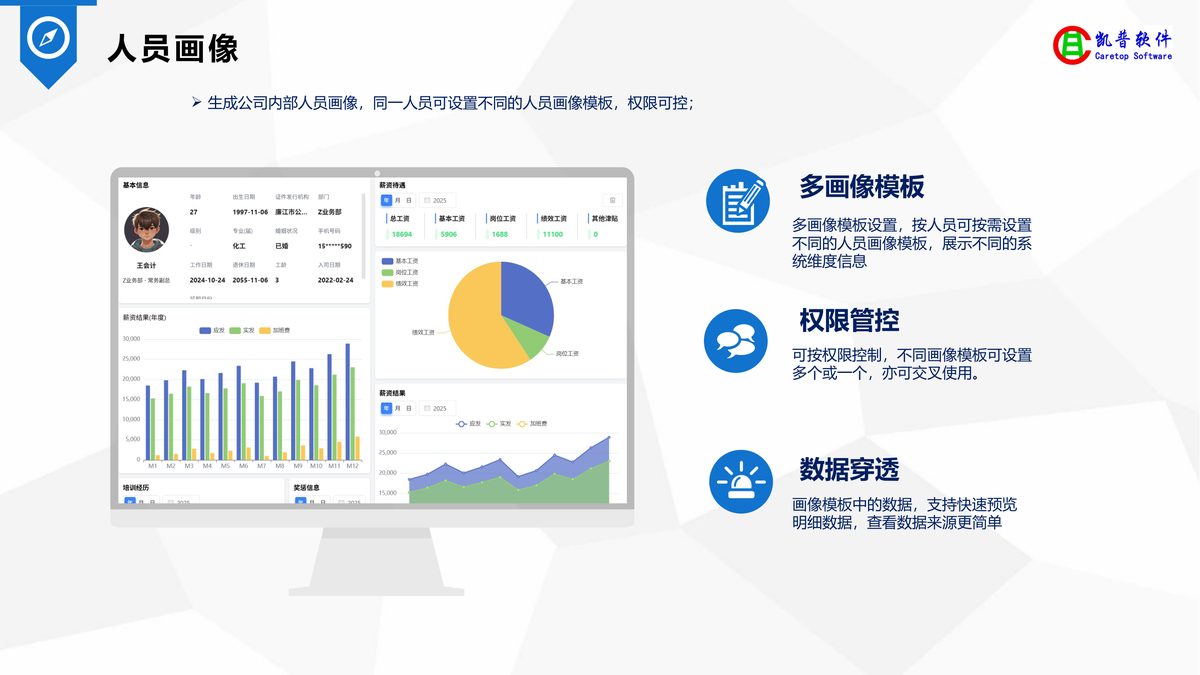
身份证号、手机号、薪资明细这类字段,是制造企业 HR 数据里最敏感的一批。系统对敏感字段的处理原则是:返回即脱敏——查询命中后,敏感字段以打星形式呈现,明文不直接出现在对话结果里。不同角色能看到的字段范围,仍由系统里的字段权限决定。
这不是把敏感数据「藏起来」那么简单,而是把字段级的可见性做成配置:哪些岗位可看完整号码、哪些只看后四位、哪些完全不可见,都在系统里事先约定。AI 只是执行这套约定。
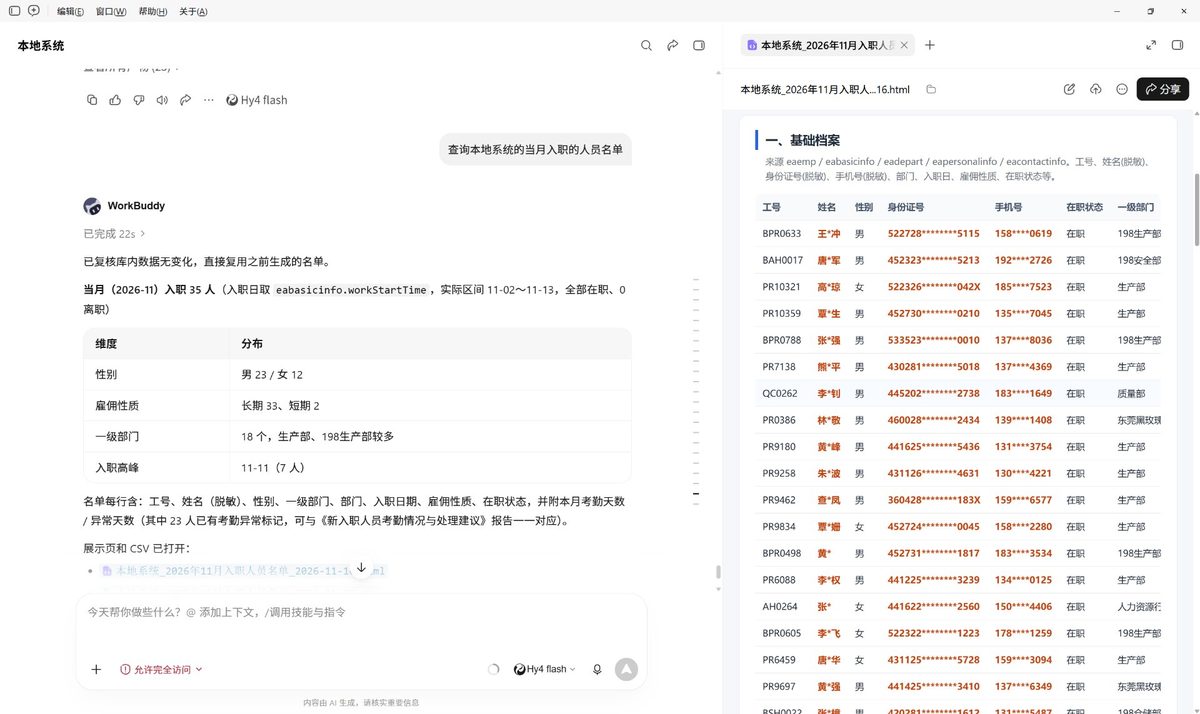
四、走功能接口,不走数据库直连,权限不可绕过
权限会不会被绕过,取决于 AI 用什么方式取数。这里的做法是:查询走 HR 系统现有的功能接口,而不是直连数据库。接口层本身就带着权限过滤,请求进来先校验身份与范围,再决定返回什么。换句话讲,AI 拿到的数据,和你自己在系统界面上点出来的,走的是同一道门。
对企业管理者来说,这意味着不用为 AI 单独设计一套安全规则——系统现有的账号体系、组织分权、字段权限,就是 AI 的天花板。工具更顺手了,边界一点没松。